Det finns ingen bästa AI-modell: det som faktiskt spelar roll 2026
OpenAI, Claude, Grok, Gemini och allt starkare modeller med öppna vikter tar olika vägar. Vad bör företag jämföra, och vad betyder computer use, beräkningskapacitet och AGI-debatten i praktiken?
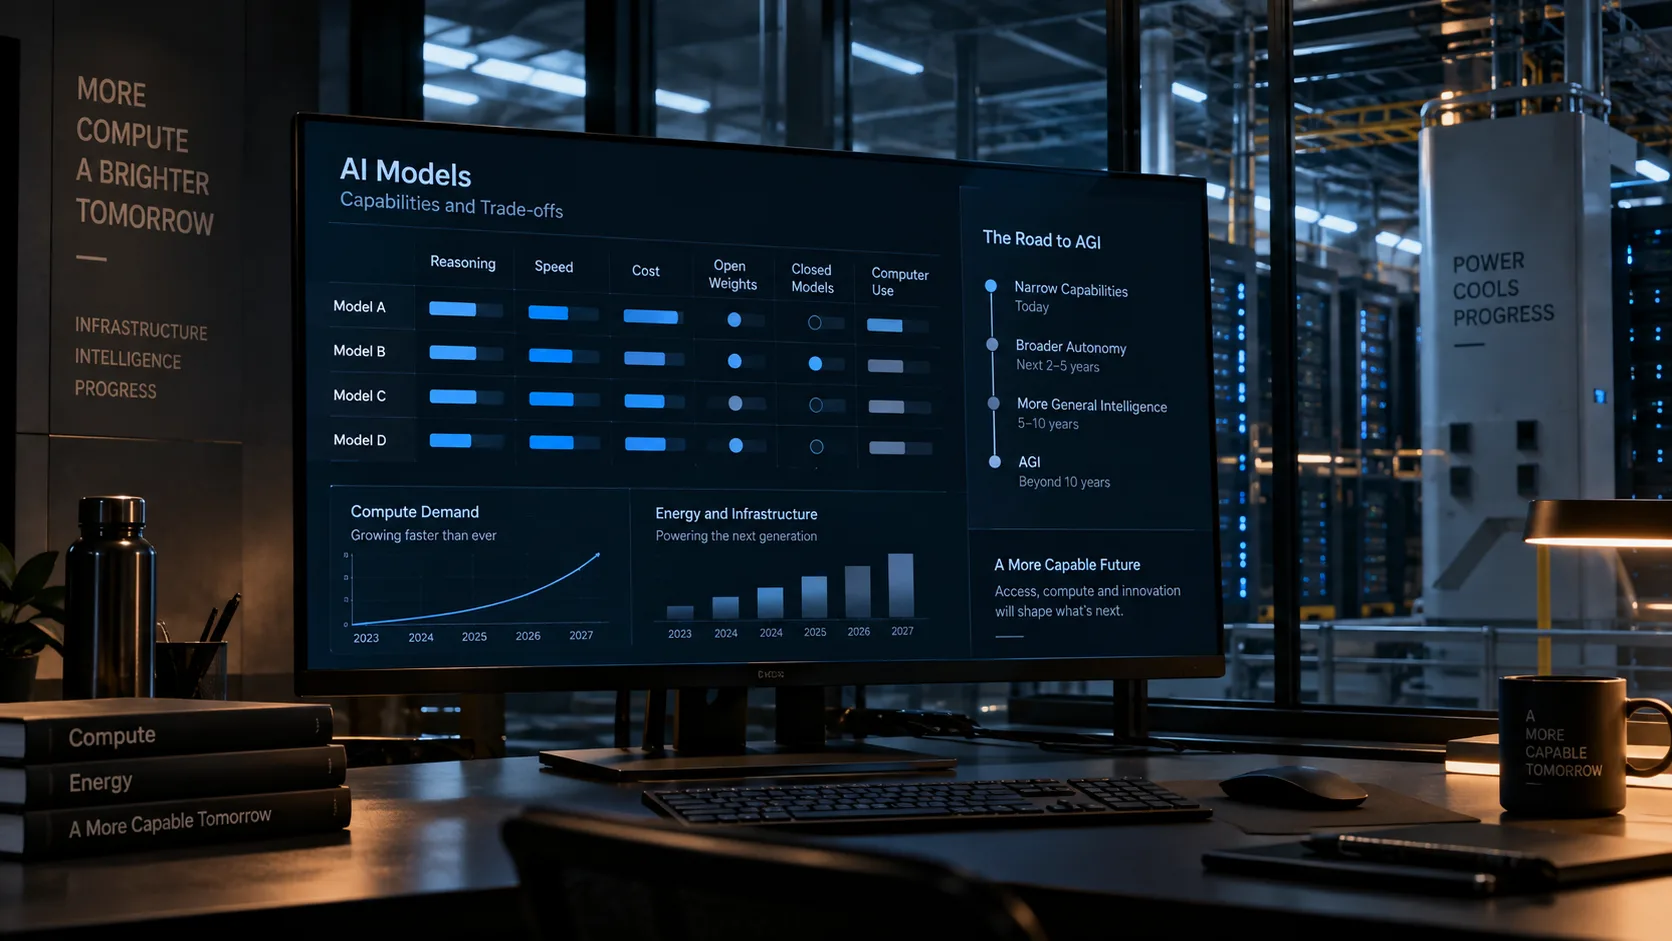
För några år sedan lät frågan ”vilken AI-modell är bäst?” rimlig. År 2026 har den blivit betydligt mindre användbar. OpenAI, Anthropic, Google, xAI och en växande grupp kinesiska utvecklare och projekt med öppna modellvikter bygger mycket kapabla system, men de är inte optimerade för exakt samma arbete. En modell kan vara starkare på långa resonemang, en annan snabbare och billigare vid stora volymer, en tredje intressant för att den kan använda vanlig programvara och en fjärde för att företaget kan kontrollera en större del av tekniken självt.
För ett litet eller medelstort företag är det goda nyheter. Man behöver inte välja ett AI-varumärke och förbli lojalt mot det. Det viktiga är att förstå det egna arbetet tillräckligt väl för att välja rätt balans mellan intelligens, hastighet, tillförlitlighet, kontroll och kostnad för varje uppgift. Så tänker vi allt oftare när vi bygger med AI på ARKARA. Vilken logotyp som toppar en benchmark den här månaden är mindre intressant än om modellen gör det verkliga jobbet tillförlitligt i systemet runt omkring.
Den starkaste modellen är sällan rätt för allt
Toppen av marknaden rör sig ovanligt snabbt. OpenAI släppte GPT-6 Astra den 3 september 2026 och lyfte fram computer use som en central funktion. OpenAI, GPT-6 Astra Anthropic lanserade Claude Fable 5.1 den 1 september. Anthropic, models overview Google gjorde Gemini 3.8 Flash allmänt tillgänglig den 2 september. Google, Gemini API changelog xAI:s Grok 4.6 kom i augusti med ett kontextfönster på 500 000 tokens. xAI, models En artikel som försöker utse en permanent vinnare bland de systemen kommer sannolikt att åldras snabbare än själva resonemanget.
Priset är en mer varaktig del av jämförelsen. GPT-6 Astra listas till 10 dollar per miljon input-tokens och 50 dollar per miljon output-tokens, medan billigare modeller hos samma leverantör kostar en liten del av det. OpenAI, pricing Anthropic och xAI har också tydliga prisskillnader mellan olika kapacitetsnivåer. Om ett företag ska klassificera tusentals rutinärenden, plocka ut standardfält eller skriva korta interna sammanfattningar kan maximal resonemangskapacitet i varje anrop vara slöseri. Det omvända gäller också: en svag modell på en svår uppgift kan bli falsk ekonomi när omkörningar, mänsklig rättning och dyra fel räknas in.
Vi skulle därför börja med arbetsbelastningen, inte varumärket. Hur svårt är resonemanget? Vad händer om svaret blir fel? Hur stor volym ska systemet hantera? Hur snabbt måste det svara? Behöver det verktyg, långt kontextfönster, bildförståelse eller computer use? De frågorna säger ofta mer än några poäng på en benchmark.
Leverantörerna blir olika verktyg, inte bara konkurrenter
De stora leverantörerna har allt tydligare styrkor även om de förändras med varje release. OpenAI har drivit mot resonemang, verktygsanvändning och arbete över flera applikationer. Anthropic och Claude har blivit särskilt synliga inom kodning och agentarbete, och företagets computer-use-verktyg lämnade beta i augusti 2026. Anthropic, release notes Google kombinerar Gemini med ett brett ekosystem för sök, produktivitet och molntjänster, medan xAI positionerar Grok 4.6 för bland annat kodning och agentbaserat arbete. xAI, release notes
Det är inte permanenta etiketter. Att säga att en viss modell ”är modellen för kodning” kan vara fel redan vid nästa version. En mer hållbar jämförelse är att köra samma verkliga arbetsuppgift genom flera kandidater och mäta kvalitet, felfrekvens, svarstid, verktygens tillförlitlighet och kostnad. Benchmarks kan hjälpa till att skapa en kortlista. De bör inte fatta inköpsbeslutet.
Öppna modellvikter flyttar kontrollen över säkerhetsgränserna
Kapabla modeller med öppna vikter har förändrat diskussionen eftersom valet inte längre bara handlar om vilket hostat API som ska anropas. DeepSeek publicerade DeepSeek-V4-Pro under MIT-licens i augusti 2026, och modellfamiljer som Alibabas Qwen och Moonshots Kimi har fortsatt släppa stora modeller med öppna vikter för kodning, resonemang och agentarbete. DeepSeek-V4-Pro model card Attraktionen är kontroll. En organisation kan i vissa fall köra modellen på infrastruktur den själv väljer, hålla mer data i en miljö den styr, anpassa systemet till ett specialområde och minska beroendet av en enda leverantör.
Den friheten har en säkerhetsmässig baksida. De begränsningar en vanlig användare möter i en hostad tjänst ligger inte enbart inne i själva modellen. De kommer också från lagren runt omkring: policyer, klassificerare, övervakning, åtkomstkontroller, verktygsbehörigheter och leverantörens möjlighet att stänga av eller förändra tjänsten. När en operatör kontrollerar både modellvikterna och systemen runt modellen kan dessa begränsningar ändras mycket djupare än vad en vanlig användare av en sluten tjänst kan göra.
Det här är inte bara en teoretisk risk. OpenAI har publicerat forskning där företaget avsiktligt finjusterade en modell med öppna vikter för att ta bort vägran att utföra vissa typer av uppgifter, just för att uppskatta värsta tänkbara risk före en release. OpenAI, Estimating worst-case frontier risks of open-weight LLMs International AI Safety Report 2026 beskriver samma avvägning mer övergripande: öppna vikter stödjer forskning och innovation, men gör skydd enklare att ta bort, användningen svårare att övervaka och en redan publicerad modell omöjlig att återkalla på samma sätt som en hostad tjänst. International AI Safety Report 2026
Det betyder inte att öppna modeller är ett dåligt val. Att koncentrera avancerad AI hos några få privata företag skapar en annan risk eftersom de företagen kontrollerar åtkomst, policy och pris. Öppna modeller sprider kapacitet och kontroll, inklusive risken för missbruk. Slutna modeller ger leverantören bättre möjlighet att upprätthålla centrala skydd, men koncentrerar samtidigt makt. Rätt val beror därför på vad organisationen behöver skydda och vilket ansvar den faktiskt kan bära själv.
Sluten frontier-AI har också en åtkomstfråga
AI känns ovanligt tillgängligt just nu. Konsumenter och mindre företag kan använda system som kodar, forskar och använder verktyg till priset av vanliga mjukvaruabonnemang, ibland helt gratis. Det vore riskabelt att anta att den allra högsta nivån alltid kommer att prissättas så.
Frontier-modeller är dyra att bygga och köra samtidigt som leverantörerna konkurrerar hårt om användare och utvecklare. De publicerade listpriserna visar redan något viktigt: hos samma leverantör kan den mest kapabla modellen kosta många gånger mer per token än ett billigare alternativ. Vi behöver inte spekulera i läckta resultatrapporter för att se att kapacitet har olika prisnivåer.
Om avancerat resonemang fortsätter kräva mycket beräkningskraft samtidigt som leverantörerna på sikt måste skapa hållbara marginaler kan marknaden delas upp. Effektiva modeller kan bli mycket billiga för rutinjobb, medan långkörande frontier-agenter och stora compute-budgetar blir premiumresurser. Konkurrens, öppna modeller, specialiserad hårdvara och bättre inferens kan pressa åt motsatt håll. Poängen är därför inte att den bästa AI:n säkert blir dyr och exklusiv. Poängen är att dagens aggressivt konkurrensutsatta priser inte bevisar att obegränsad frontier-intelligens kommer vara lika billig för alla även i framtiden.
Computer use utvidgar vad som går att automatisera
Computer use är viktigt eftersom det når programvara som API:er inte når. Om ett CRM har ett stabilt API är det fortfarande den renare integrationen. Men många verksamheter är beroende av portaler eller äldre program utan användbart API. En modell med computer use kan arbeta med samma grafiska gränssnitt som en människa använder, läsa skärmen, klicka och skriva.
Det kan öppna processer som tidigare fastnade som manuellt arbete, men metoden är mindre förutsägbar än ett API. Gränssnitt flyttas, inloggningar går ut och oväntade tillstånd dyker upp. Både OpenAI och Anthropic levererar computer-use-funktioner med råd kring isolering, tillåtna åtgärder, steglimiter, kontroll av resultat och mänsklig kontroll över sådant som är svårt att återställa. OpenAI, computer use Vår syn är att computer use inte ersätter API:er. Det utvidgar automation till platser där en pålitlig integration saknas.
Nästa flaskhals kan vara fysisk
Mjukvara kan förbättras på några månader. Halvledarfabriker, avancerad chip-packetering, datacenter, transformatorer, kraftledningar och ny elproduktion fungerar på helt andra tidskalor. Skillnaden blir viktig när AI-användningen går från korta chatsvar till resonemangssystem och agenter som kan förbruka betydligt mer beräkningskraft under mycket längre tid.
International Energy Agency uppskattade att datacenter använde omkring 415 TWh el under 2024, ungefär 1,5 procent av världens elanvändning, och bedömde att förbrukningen kan mer än fördubblas till cirka 945 TWh 2030, med AI som en viktig drivkraft. IEA varnade också för att omkring 20 procent av planerade datacenterprojekt riskerar förseningar och att väntetiderna för kritisk nätutrustning som transformatorer och kablar har fördubblats på tre år. IEA, Energy and AI Även investeringsskalan är anmärkningsvärd: Stanford HAI:s AI Index 2026 redovisade 285,9 miljarder dollar i privata AI-investeringar i USA under 2025. Stanford HAI, 2026 AI Index
Det skapar en möjlig obalans: modellernas förmåga kan förbättras snabbare än tillräckligt mycket beräkningskapacitet och el kan byggas ut ekonomiskt. Om det händer blir effektivitet lika viktig som rå intelligens. En modell som når nästan samma resultat med hälften av beräkningsarbetet kan bli mer värdefull än en modell som vinner en benchmark med några få procentenheter.
Motargumentet är att infrastrukturen också byggs ut och att både hårdvara och algoritmer kan förbättras dramatiskt. Vi bör därför inte utgå från att den fysiska flaskhalsen permanent kommer springa ifrån branschen. Samtidigt kan billigare beräkning öka den totala efterfrågan. Om en agent blir tio gånger effektivare och företag svarar genom att köra hundra gånger fler agenter ökar ändå energianvändningen. Framtida AI-priser kommer därför att formas av chip, el, nätkapacitet och effektivitet lika mycket som av smartare modeller.
Går vi in i AGI-eran?
AGI, Artificial General Intelligence, syftar i bred mening på ett system med generell snarare än smal intelligens som kan lära sig, resonera och använda kunskap över ett stort antal olika uppgifter. Det finns ingen universellt accepterad definition och inget gemensamt test som avgör när AGI har uppnåtts. Därför har forskare föreslagit nivåer och ramverk i stället för en enda skarp gräns. Morris et al., Levels of AGI
Det optimistiska perspektivet är att allt mer generella modeller, verktygsanvändning, kodning, multimodalt resonemang och computer use visar att vi snabbt rör oss mot en sådan nivå. Motperspektivet är att bred kompetens och starka benchmark-resultat inte är samma sak som generell intelligens. Dagens system kan fortfarande misslyckas på överraskande sätt och är ofta starkt beroende av verktyg, instruktioner och den tekniska struktur som byggs runt modellen.
För ett företag kan definitionen vara mindre viktig än den praktiska kapaciteten. Ett system som förstår ett mål, hittar information, använder verktyg, arbetar i programvara och utför flera timmars användbart kognitivt arbete kan förändra verksamheten oavsett om forskare väljer att kalla det AGI.
Även om ett laboratorium bygger något som brett accepteras som AGI följer inte obegränsad tillgång automatiskt. Frågorna finns kvar: vem kontrollerar systemet, vilka skydd omger det, hur mycket beräkningskraft kräver det och vad kostar den beräkningen? Om frontier-intelligens fortsätter vara compute-intensiv kan tillgången i praktiken formas av kapital, chip och el lika mycket som av själva mjukvaran.
Därför tror vi inte att framtiden består av en modell som besegrar alla andra och blir det permanenta svaret för varje företag. Troligare är ett lager av modeller med olika styrkor, priser och grad av öppenhet under produkter som användaren allt mer bedömer efter resultat i stället för modellnamn. Den hållbara frågan är inte vilken leverantör som leder just den här månaden. Den är vilket arbete vi vill att mjukvara ska kunna göra, hur mycket ansvar vi är beredda att ge den och vad det kommer att kosta att leverera den förmågan på ett tillförlitligt sätt.